[Spring] MyBatis 사용법 - JPA와 차이점을 중심으로
DB접근기술로 Jpa만 사용하던 나는 며칠전 개발자로 처음 회사에 입사하게 되었다.
곧 개발에 착수하는 프로젝트는 아마 MyBatis를 쓰게 될 가능성이 높다고 하였다.
그래서 허겁지겁 MyBatis에 대해 공부하기 시작했다.
그리고 나처럼 기존 JPA에 익숙한 사람들을 위해 JPA를 기준으로 차이점을 들어 설명하려고 한다.
1.스프링 부트에서 일단 마이바티스 의존성을 추가하기 위해서는 아래와 같이 추가해야한다.
implementation 'org.springframework.boot:spring-boot-starter-data-jdbc'
implementation 'org.mybatis.spring.boot:mybatis-spring-boot-starter:2.2.0'
2.application.yml에 mapper파일(mybatis 쿼리 파일)의 위치를 명시한다.
mybatis:
  mapper-locations: classpath:/mapper/**/*.xml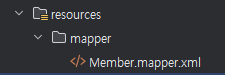
그런데 사실 mapper-locations설정을 생략해도 마이바티스는 기본 경로를 자동으로 찾는다.
기본경로는 resources아래의 mapper파일 아래로 저렇게 파일이 세팅되어있다면 설정파일(application.yml)에 위치를 명시하지 않아도 문제가 없으나 만약 다른 경로에 mapper.xml파일이 존재한다면 그 땐, 그 경로를 설정파일에 명시해주어야한다.
3.마이바티스 쿼리 결과를 매핑할 용도의 객체(POJO 클래스)를 만든다.
POJO : Plain Old Java Object. 즉 예전 방식의 평범한 객체 라는 뜻으로 어떤 특정 프레임워크라 라이브러리의 종속되지 않은, getter/setter 정도만 가진 순수한 데이터 클래스를 POJO라고 한다.
여기가 좀 어색한 부분인 것 같다.
우리가 JPA를 사용했을 때는 아래 처럼 가장 먼저 엔티티 클래스를 만들었다.
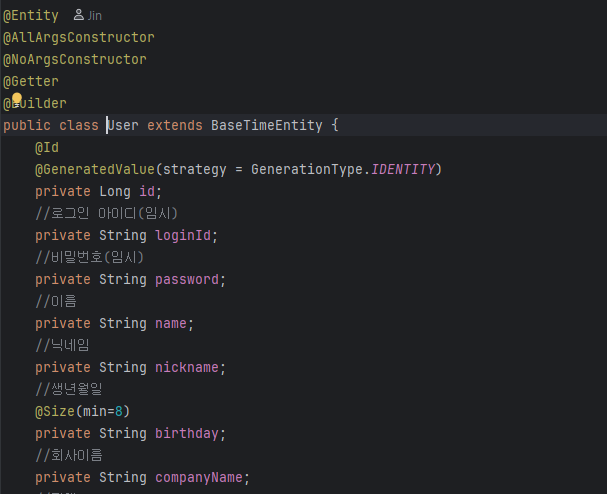
그리고 DB와 접근하는 Jpa레포지토리로부터 보통은 해당 엔티티 객체로 리턴받아 이를 서비스 계층에서 필요에 맞게
DTO객체로 조립하여 클라이언트에게 리턴하는 것이 일반적이었다. 그리고 이렇게 엔티티 클래스가 있어야 DB에 자동으로 테이블도 만들어지기도 했다.
| 개발 철학 | 객체 중심 (OOP 기반) | SQL 중심 (RDB 기반) |
| 핵심 역할 | @Entity가 DB 테이블과 직접 매핑 | POJO 클래스는 단순히 쿼리 결과를 담는 용도 |
| 필수 클래스 | @Entity 클래스 필수 | POJO 클래스 없어도 되지만 있는 게 좋음 |
그런데 MyBatis는 JPA와 철학 자체가 다르다.
그러므로 엔티티객체도 필요없고 단순히 쿼리를 날린 결과를 담는 용도의 순수 데이터 객체만 있으면 되는 것이다.
그리고 JPA는 @Entity 클래스에 맞게 자동으로 DB에 테이블을 생성해주었지만,
MyBatis는 개발자가 직접 SQL문을 작성하여 DB에 먼저 테이블을 수동으로 만들어야한다.
*나는 개인적으로 이 대목에서 특히 JPA가 편리하다고 생각한다...
그럼 그냥 단순하게 로그인 아이디와 닉네임을 받아오는 쿼리를 날린다 생각하고 아래 DTO에 매핑하여 받으려고 한다면 아래의 클래스가 있어야한다.
public class UserDto {
    private String loginId;
    private String nickname;
}
4.Mapper 인터페이스 만든다.
Mapper 인터페이스는 우리가 mapper.xml파일에 작성할 SQL을 호출하기 위한 자바 인터페이스다.
이곳에서 우리는 SQL을 실행할 메서드를 정의해놓아야한다. 여기에 작성하는 메서드는 mapper.xml파일의 쿼리와 1:1매핑되어 실제 쿼리를 실행하게 된다.
이렇게 Mapper어노테이션이 필수다. 그리고 우리가 인터페이스인 JpaRepository를 사용할 때는 메서드를 우리 마음대로 작성하면 안되었다. 메서드명을 기반으로 구현체인 Hibernate가 내부적으로 쿼리를 실행하기 때문이다.
하지만 Mapper 인터페이스에서 메서드명은 개발자가 자유롭게 지어도 된다. 어차피 mapper.xml파일에서 수동으로 1:1매칭시킬 것이기 때문이다.
@Mapper
public interface UserMapper {
    UserDto findUserIdAndNickname(Long id);
}
5.mapper.xml파일을 만든다.
<?xml version="1.0" encoding="UTF-8" ?>
<!DOCTYPE mapper PUBLIC "-//mybatis.org//DTD Mapper 3.0//EN"
        "http://mybatis.org/dtd/mybatis-3-mapper.dtd">

<!--Mapper 인터페이스의 경로를 명시-->
<mapper namespace="com.beyond.basic.b2_board.mapper.UserMapper">

    <!--select 부분은 DML문(select,incert,update,delete)중에 하나를 명시-->
    <!--id 부분에는 Mapper인터페이스에 명시했고, 이 쿼리와 매칭될 메서드명    -->
    <!--resultType에는 쿼리결과로 리턴받을 객체 경로를 명시    -->
    <!-- login_id 뒤에 AS 로 alias를 쓴 경우는 db의 컬럼명과 UserDto의 컬럼명이 일치하지 않기 때문 MyBatis에서는 UserDto의 컬럼명과 맞춰야하기때문에 AS사용   -->
    <select id="findUserIdAndNickname" resultType="com.beyond.basic.b2_board.domain.UserDto">
        SELECT m.login_id AS loginId, m.nickname FROM member m WHERE id = #{id}
    </select>
</mapper>
이렇게 하면 이제 서비스단에서 findUserIdAndNickname 메서드를 사용할 수 있는 것이다.
MyBatis는 SQL 자체를 제어할 수 있다는 점에서 복잡한 SQL,조인,서브쿼리 등을 직접 작성 가능하다는 장점이 있다.
JPA는 압도적으로 나은 생산성에 장점이 있다.
아래를 보면 JPA냐 MyBatis냐 어떤 기술을 선택할 지 좋은 기준이 될 듯하다.
그리고 단순 CRUD는 JPA를 사용하면 복잡한 JOIN은 MyBatis를 사용하는 식으로 혼용방식도 사용하는 곳이 많다고 하니 참고하면 좋을 듯하다.
💬 JPA 선택 이유:
- 신규 프로젝트고 CRUD 중심이면 개발 속도가 중요
- 도메인 중심으로 객체 모델 설계를 잘 하고 싶을 때
- 스프링 생태계에 익숙한 인원이 많을 때
- 복잡한 연관관계와 트랜잭션 일관성이 중요할 때
💬 MyBatis 선택 이유:
- 쿼리 성능이 매우 중요한 서비스 (검색, 분석, 금융, 게임 등)
- SQL 튜닝을 많이 해야 하는 경우
- DB 스키마가 매우 복잡하거나, 다른 팀(DBA)에서 쿼리를 관리하는 구조
- 기존 레거시 시스템이 MyBatis 기반일 때